machine learning supervised unsupervised คือ — วิธีตั้งค่าและใช้งานจริงพร้อมตัวอย่าง
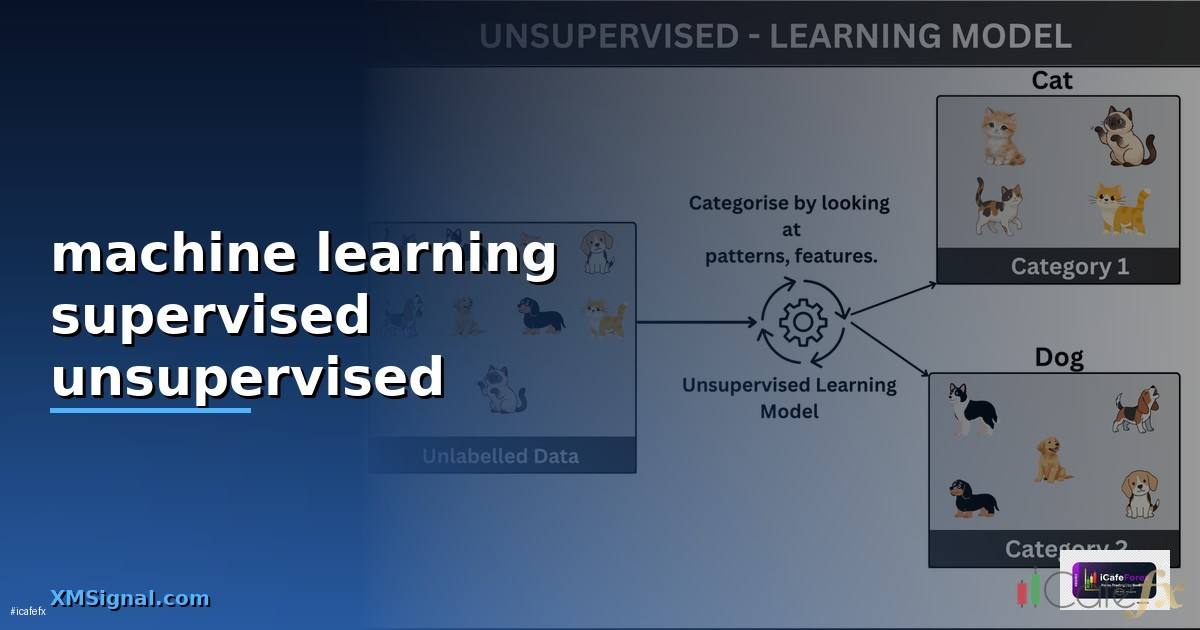
Machine Learning แบบ Supervised กับ Unsupervised คืออะไร — อธิบายจากประสบการณ์ใช้งานจริง
Machine Learning แบบ Supervised และ Unsupervised คือสองแนวทางหลักของการสอนให้คอมพิวเตอร์เรียนรู้จากข้อมูล
ต่างกันที่วิธีการให้ข้อมูลและเป้าหมายปลายทาง Supervised Learning คือการเรียนรู้แบบมีครู เรามีข้อมูลตัวอย่างพร้อมคำตอบอยู่แล้ว เช่น ราคาแท่งเทียนย้อนหลังพร้อมป้ายกำกับว่าแท่งไหน "ขึ้น" แท่งไหน "ลง" แล้วให้โมเดลเรียนรู้รูปแบบที่นำไปสู่คำตอบเหล่านั้น ส่วน Unsupervised Learning คือการเรียนรู้แบบไม่มีครู เราโยนข้อมูลดิบให้โมเดลแล้วให้มันหาโครงสร้างหรือกลุ่มที่ซ่อนอยู่เอง เช่น การจัดกลุ่มพฤติกรรมผู้ใช้เว็บไซต์ที่เรายังไม่รู้ว่ามีกี่กลุ่ม
ทำไมสองแนวทางนี้ถึงสำคัญกับคนทำงานสายไอทีและเทรดเดอร์อย่างเรา ในยุคปี 2026 ที่ข้อมูลมีปริมาณมหาศาล การมานั่งวิเคราะห์ด้วยมือแบบเมื่อสิบปีก่อนไม่ไหวอีกต่อไป ผมเทรดฟอเร็กซ์กับ XM มากว่า 13 ปี และหลายปีที่ผ่านมาผมใช้โมเดล Supervised ช่วยกรองสัญญาณเข้าออเดอร์ ใช้โมเดล Unsupervised ช่วยหา pattern ตลาดใหม่ ๆ ที่สายตามนุษย์มองไม่เห็น ผลลัพธ์คือความแม่นยำในการตัดสินใจดีขึ้นชัดเจน
ข้อแตกต่างโดยสรุปมีดังนี้
| หัวข้อเปรียบเทียบ | Supervised Learning | Unsupervised Learning |
|---|---|---|
| ข้อมูลที่ใช้ | มีคำตอบกำกับ (label) | ไม่มีคำตอบกำกับ |
| เป้าหมาย | ทำนายผลลัพธ์ | หาโครงสร้างหรือกลุ่ม |
| ตัวอย่างงาน | ทำนายราคา จำแนกสแปม | แบ่งกลุ่มลูกค้า ลดมิติข้อมูล |
| อัลกอริทึมยอดนิยม | ต้นไม้ตัดสินใจ, การถดถอยเชิงเส้น | การจัดกลุ่ม K-Means, การวิเคราะห์องค์ประกอบหลัก |
| ความยากในการเริ่มต้น | ต้องมีข้อมูลคุณภาพดีพร้อมป้ายกำกับ | ตีความผลลัพธ์ต้องใช้ประสบการณ์ |
สิ่งที่ผมอยากให้จำกันคือ สองแนวทางนี้ไม่ได้แข่งกันแต่เสริมกัน ในระบบจริงเรามักใช้ Unsupervised สำรวจข้อมูลก่อน แล้วค่อยใช้ Supervised สร้างโมเดลทำนายบนความเข้าใจที่ได้มา
ผู้เริ่มต้นส่วนใหญ่พลาดตรงที่กระโดดไปหยิบเครื่องมือมาใช้ทันทีโดยไม่ถามตัวเองก่อนว่างานที่ทำอยู่เป็นประเภทไหน
ผลคือเสียเวลาเป็นสัปดาห์กับโมเดลที่ไม่ตอบโจทย์ ถ้างานของคุณมีคำตอบชัดเจนในอดีตอยู่แล้ว เช่น ต้องการทำนายว่าลูกค้าจะยกเลิกสมาชิกหรือไม่ ซึ่งเรารู้คำตอบของลูกค้าเก่าอยู่แล้ว นั่นคืองาน Supervised ทันที แต่ถ้าคำถามของคุณคือ "ข้อมูลชุดนี้มีอะไรที่น่าสนใจซ่อนอยู่" เช่น อยากรู้ว่าสไตล์การเทรดของลูกค้าในระบบแบ่งออกเป็นกี่ประเภท นั่นคืองาน Unsupervised
ผู้เริ่มต้นส่วนใหญ่พลาดตรงที่กระโดดไปหยิบเครื่องมือมาใช้ทันทีโดยไม่ถามตัวเองก่อนว่างานที่ทำอยู่เป็นประเภทไหน ผลคือเสียเวลาเป็นสัปดาห์กับโมเดลที่ไม่ตอบโจทย์ ถ้างานของคุณมีคำตอบชัดเจนในอดีตอยู่แล้ว เช่น ต้องการทำนายว่าลูกค้าจะยกเลิกสมาชิกหรือไม่ ซึ่งเรารู้คำตอบของลูกค้าเก่าอยู่แล้ว นั่นคืองาน Supervised ทันที แต่ถ้าคำถามของคุณคือ "ข้อมูลชุดนี้มีอะไรที่น่าสนใจซ่อนอยู่" เช่น อยากรู้ว่าสไตล์การเทรดของลูกค้าในระบบแบ่งออกเป็นกี่ประเภท นั่นคืองาน Unsupervised
จากมุมมองของคนดูแลระบบและนักพัฒนา การเข้าใจความต่างนี้ช่วยในเรื่องการวางแผนต้นทุนด้วย เพราะงาน Supervised มักใช้เวลาและงบประมาณไปกับการเก็บและตรวจสอบป้ายกำกับข้อมูล ซึ่งเป็นขั้นตอนที่คนมักประเมินต่ำที่สุด ผมเคยเห็นทีมหนึ่งตั้งใจสร้างโมเดลทำนายผลเทรด ใช้เวลาสองเดือนเขียนโค้ด แต่ใช้เวลาเกือบหกเดือนไปกับการตรวจป้ายกำกับข้อมูลราคาย้อนหลัง เพราะข้อมูลตลาดมี noise เยอะและคำนิยามของ "เข้าทำกำไร" ก็กำหนดได้หลายแบบ
อีกเหตุผลที่ต้องเข้าใจทั้งสองแบบคือการประเมินผลลัพธ์ต่างกันโดยสิ้นเชิง โมเดล Supervised วัดกันด้วยความแม่นยำ ตัวชี้วัดความแม่นยำสมดุล หรือค่าความคลาดเคลื่อนกำลังสอง ส่วนโมเดล Unsupervised ไม่มีคำตอบจริงให้เทียบ ต้องวัดด้วยเกณฑ์ภายใน เช่น ความหนาแน่นของกลุ่ม หรือต้องให้ผู้เชี่ยวชาญด้านเนื้อหาตีความว่ากลุ่มที่ได้มีความหมายทางธุรกิจหรือไม่ ถ้าคุณตั้งค่าระบบแล้วคาดหวังว่าจะมี "คะแนนความถูกต้อง" จากโมเดล Unsupervised จะผิดหวังและอาจตัดสินใจผิดพลาดในการนำไปใช้
ก่อนลงมือตั้งค่าอะไร ต้องเตรียมสภาพแวดล้อมให้พร้อมก่อน เครื่องมือหลักที่ผมใช้และแนะนำในปี 2026 คือภาษาไพธอนคู่กับไลบรารี scikit-learn
สำหรับโมเดลพื้นฐานทั้งสองแบบ และไลบรารีหนัก ๆ อย่าง TensorFlow หรือ PyTorch เฉพาะเมื่องานต้องใช้โครงข่ายประสาทเทียมจริง ๆ อย่าเพิ่งกระโดดไปใช้ของหนักตั้งแต่แรก เพราะโจทย์ส่วนใหญ่ที่คนถามผมมา จัดการด้วย scikit-learn ได้หมด
เตรียมสภาพแวดล้อมและเครื่องมือก่อนเริ่มต้น
ก่อนลงมือตั้งค่าอะไร ต้องเตรียมสภาพแวดล้อมให้พร้อมก่อน เครื่องมือหลักที่ผมใช้และแนะนำในปี 2026 คือภาษาไพธอนคู่กับไลบรารี scikit-learn สำหรับโมเดลพื้นฐานทั้งสองแบบ และไลบรารีหนัก ๆ อย่าง TensorFlow หรือ PyTorch เฉพาะเมื่องานต้องใช้โครงข่ายประสาทเทียมจริง ๆ อย่าเพิ่งกระโดดไปใช้ของหนักตั้งแต่แรก เพราะโจทย์ส่วนใหญ่ที่คนถามผมมา จัดการด้วย scikit-learn ได้หมด
ขั้นตอนการติดตั้งเริ่มจากสร้างสภาพแวดล้อมเสมือนเพื่อแยกโปรเจกต์ ใช้คำสั่ง `python -m venv venv` จากนั้นเปิดใช้งานด้วย `source venv/bin/activate` บนลินุกซ์หรือแมค แล้วติดตั้งแพ็กเกจหลักด้วย `pip install scikit-learn pandas numpy matplotlib jupyter` ชุดนี้เพียงพอสำหรับเริ่มทั้ง Supervised และ Unsupervised แล้ว ข้อดีของการใช้สภาพแวดล้อมเสมือนคือไม่ทำให้แพ็กเกจในเครื่องหลักพัง ประสบการณ์ผมคือปัญหาความเข้ากันได้ของเวอร์ชันเป็นสาเหตุอันดับต้น ๆ ที่ทำให้มือใหม่ถอดใจกลางทาง
เมื่อสภาพแวดล้อมพร้อมแล้ว มาลงมือจริงกับโมเดล Supervised ตัวอย่างที่ผมจะแสดงคือการจำแนกข้อมูลด้วยอัลกอริทึมป่าสุ่ม
ซึ่งเป็นตัวเลือกที่ดีสำหรับมือใหม่เพราะใช้ง่าย ทนทานต่อข้อมูลผิดปกติ และให้ผลดีทันทีโดยไม่ต้องปรับค่ามาก
อีกจุดที่มักถูกมองข้ามคือการจัดเก็บข้อมูล ควรแยกข้อมูลดิบ ข้อมูลที่ผ่านการทำความสะอาด และข้อมูลที่ใช้เทรนออกจากกันเป็นโฟลเดอร์ชัดเจน และควรเก็บโค้ดทั้งหมดในระบบควบคุมเวอร์ชันอย่าง Git ผมเคยเสียเวลาหลายวันเพราะแก้ไฟล์ข้อมูลทับต้นฉบับโดยไม่มีสำรอง ตั้งแต่วันนั้นมากฎของผมคือห้ามแตะไฟล์ข้อมูลดิบเด็ดขาด ทุกการแปลงต้องเกิดในโค้ดเท่านั้น วิธีนี้ทำให้ทำซ้ำผลลัพธ์ได้เสมอ ซึ่งเป็นหัวใจของงานด้านนี้ทั้งหมด
วิธีตั้งค่าและเทรนโมเดล Supervised ทีละขั้น
เมื่อสภาพแวดล้อมพร้อมแล้ว มาลงมือจริงกับโมเดล Supervised ตัวอย่างที่ผมจะแสดงคือการจำแนกข้อมูลด้วยอัลกอริทึมป่าสุ่ม ซึ่งเป็นตัวเลือกที่ดีสำหรับมือใหม่เพราะใช้ง่าย ทนทานต่อข้อมูลผิดปกติ และให้ผลดีทันทีโดยไม่ต้องปรับค่ามาก
from sklearn.modelselection import traintest_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import classification_report import pandas as pd
data = pd.read_csv('ข้อมูลตัวอย่าง.csv') X = data.drop('ผลลัพธ์', axis=1) y = data['ผลลัพธ์']
Xtrain, Xtest, ytrain, ytest = traintestsplit( X, y, testsize=0.2, randomstate=42, stratify=y )
model = RandomForestClassifier(nestimators=200, maxdepth=10, random_state=42) model.fit(Xtrain, ytrain)
predictions = model.predict(X_test) print(classificationreport(ytest, predictions))
ต่อไปคือฝั่ง Unsupervised ซึ่งงานที่ใช้บ่อยที่สุดคือการจัดกลุ่มข้อมูลด้วย K-Means
ตัวอย่างที่ผมใช้จริงคือการแบ่งกลุ่มรูปแบบการเทรดของผู้ใช้ในระบบสัญญาณ โดยใช้ลักษณะอย่างความถี่เข้าออเดอร์ ขนาดล็อตเฉลี่ย คู่เงินที่ชอบ และระยะเวลาถือครอง โค้ดเริ่มต้นมีดังนี้
อีกจุดที่คนพลาดบ่อยคือการปรับค่าพารามิเตอร์โดยดูผลจากชุดทดสอบ ทำซ้ำหลายรอบจนชุดทดสอบไม่ใช่ข้อมูลใหม่อีกต่อไป วิธีที่ถูกต้องคือแบ่งข้อมูลสามส่วน เทรน ตรวจสอบ และทดสอบ ปรับค่าโดยดูส่วนตรวจสอบเท่านั้น แล้วเปิดส่วนทดสอบครั้งเดียวในตอนจบ หรือใช้เทคนิคการตรวจสอบไขว้แบบกลุ่มซ้อนที่ scikit-learn มีให้พร้อมอยู่แล้วผ่านฟังก์ชัน `GridSearchCV`
สำหรับงานทำนายค่าตัวเลขต่อเนื่อง เช่น ทำนายราคาพรุ่งนี้ว่าจะอยู่ที่เท่าไร ให้เปลี่ยนจากตัวจำแนกเป็นตัวถดถอย เช่น `RandomForestRegressor` และเปลี่ยนตัวชี้วัดจากความแม่นยำเป็นค่าความคลาดเคลื่อนเฉลี่ย ทุกอย่างอื่นทำเหมือนเดิม โครงสร้างของ scikit-learn ทำให้สลับอัลกอริทึมได้แทบไม่ต้องแก้โค้ด ลองเทียบหลายโมเดลก่อนตัดสินใจใช้ตัวใดตัวหนึ่งเป็นตัวหลักเสมอ
วิธีตั้งค่าและใช้งาน Unsupervised Learning ในทางปฏิบัติ
ต่อไปคือฝั่ง Unsupervised ซึ่งงานที่ใช้บ่อยที่สุดคือการจัดกลุ่มข้อมูลด้วย K-Means ตัวอย่างที่ผมใช้จริงคือการแบ่งกลุ่มรูปแบบการเทรดของผู้ใช้ในระบบสัญญาณ โดยใช้ลักษณะอย่างความถี่เข้าออเดอร์ ขนาดล็อตเฉลี่ย คู่เงินที่ชอบ และระยะเวลาถือครอง โค้ดเริ่มต้นมีดังนี้
from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler import pandas as pd
data = pd.read_csv('ข้อมูลพฤติกรรม.csv') features = data[['ความถี่', 'ขนาดล็อต', 'ระยะเวลาถือครอง']]
scaler = StandardScaler() scaled = scaler.fit_transform(features)
inertias = [] for k in range(2, 11): km = KMeans(nclusters=k, randomstate=42, n_init=10) km.fit(scaled) inertias.append(km.inertia_)
จุดที่ต้องระวังที่สุดของ Unsupervised คือการปรับมาตรฐานข้อมูลก่อนเสมอ เพราะ K-Means คำนวณจากระยะทาง ถ้าตัวแปรหนึ่งมีค่าเป็นพันและอีกตัวเป็นทศนิยม ตัวที่ค่าใหญ่จะกลืนตัวที่ค่าเล็กหมด ผลจัดกลุ่มจะผิดไปทั้งหมดโดยที่โค้ดไม่ฟ้องอะไรเลย ผมเห็นงานที่จัดกลุ่มผิดเพราะลืมขั้นตอนนี้หลายครั้งจนต้องย้ำกับทุกทีมที่ผมโค้ช
อีกคำถามยอดฮิตคือจะรู้ได้อย่างไรว่าควรแบ่งกี่กลุ่ม วิธีดูกราฟค่าความเฉื่อยแบบข้อศอกเป็นจุดเริ่มที่ดี ให้เลือกค่าที่กราฟเริ่มแบนลง นอกจากนี้ให้ใช้ดุลยพินิจทางธุรกิจประกอบ เพราะการแบ่งสิบกลุ่มอาจให้ค่าความเฉื่อยดีกว่าสามกลุ่ม แต่ถ้าทีมการตลาดดูแลได้แค่สามกลุ่มจริง ก็ไม่มีประโยชน์
งาน Unsupervised อีกประเภทที่มีประโยชน์มากคือการลดมิติข้อมูลเพื่อทำภาพรวม ใช้ `PCA` จาก scikit-learn ลดข้อมูลหลายสิบมิติให้เหลือสองมิติแล้วพล็อตดู บางทีก็เจอความผิดปกติในข้อมูลได้จากภาพเลย ผมใช้วิธีนี้ตรวจข้อมูลก่อนเทรนโมเดล Supervised ทุกครั้ง เห็นข้อมูลแปลก ๆ เช่น จุดที่หลุดกลุ่ม ก็จะไล่หาสาเหตุก่อน ไม่ใช่ปล่อยให้โมเดลเรียนรู้จากข้อมูลมีมลภาวะ
ตัวอย่างการนำไปใช้งานจริงและปัญหาที่พบบ่อย
ตัวอย่างงานจริงที่ผมดูแลอยู่ในระบบสัญญาณของเรา มีการใช้สองแนวทางร่วมกันแบบนี้ ขั้นแรกใช้การจัดกลุ่มแบ่งวันเทรดออกเป็นกลุ่มตามลักษณะตลาด เช่น กลุ่มตลาดไปทางเดียวชัดเจน กลุ่มตลาดออกข้าง และกลุ่มตลาดผันผวนสูง จากนั้นสร้างโมเดลจำแนกแยกต่างหากในแต่ละกลุ่ม เพราะกลยุทธ์ที่เวิร์กในตลาดไปทางเดียวอาจกินขาดในตลาดออกข้าง ผลคือความแม่นยำรวมดีขึ้นกว่าการใช้โมเดลเดียวครอบทุกสภาวะตลาดอย่างชัดเจน
ปัญหาที่พบบ่อยอันดับหนึ่งคือข้อมูลไม่สมดุล เช่น ในข้อมูลเทรด รายการที่ขาดทุนมีมากกว่าทำกำไรเสมอ โมเดลจะเรียนรู้ไปทางกลุ่มเสียงข้างมากและทายขาดทุนทุกครั้งก็ยังได้ความแม่นยำสูง แต่ไม่มีประโยชน์เลย วิธีแก้คือใช้พารามิเตอร์ `class_weight='balanced'` หรือสุ่มเพิ่มตัวอย่างกลุ่มน้อย
อันดับสองคือข้อมูลรั่วจากอนาคต ในงานทำนายอนุกรมเวลาอย่างราคา ต้องระวังไม่ให้ตัวแปรใดตัวแปรหนึ่งมีข้อมูลที่ยังไม่เกิดในเวลาทำนายจริง ผมเคยทำโมเดลที่ความแม่นยำเกินเก้าสิบเปอร์เซ็นต์ ดีจนต้องสงสัย แล้วพบว่ามีตัวแปรหนึ่งคำนวณจากราคาปิดวันเดียวกันที่กำลังจะทำนาย ตอนนั้นเสียเวลาสองสัปดาห์ บทเรียนคือผลดีเกินคาดมักมีปัญหาซ่อนอยู่เสมอ
อันดับสามคือปัญหาการเลื่อนไหลของข้อมูล พฤติกรรมตลาดและพฤติกรรมผู้ใช้เปลี่ยนไปเรื่อย ๆ โมเดลที่ดีเมื่อหกเดือนก่อนอาจหมดอายุ ต้องตั้งระบบติดตามผลลัพธ์ในการใช้งานจริงและกำหนดรอบการเทรนใหม่สม่ำเสมอ เช่น ทุกเดือนหรือทุกไตรมาส ระบบด้านนี้จึงไม่ใช่งานครั้งเดียวจบ แต่เป็นการดูแลต่อเนื่องเหมือนดูแลพืชสวน ต้องรดน้ำและตัดแต่งเป็นระยะ
สำหรับมือใหม่ที่อยากเริ่มต้นวันนี้ ผมแนะนำลำดับดังนี้ เลือกชุดข้อมูลที่ตัวเองเข้าใจดีก่อน เริ่มจากโมเดลง่ายที่สุดอย่างการถดถอยเชิงเส้นหรือต้นไม้ตัดสินใจ วัดผลอย่างซื่อสัตย์ แล้วค่อยปรับปรุงทีละขั้น อย่าเปรียบเทียบกับงานคนอื่น ให้เปรียบเทียบกับตัวเองเมื่อสัปดาห์ก่อน เส้นทางแบบนี้ทำให้ไปได้ไกลกว่าการตั้งเป้าสูงเกินแล้วท้อกลางทาง
คำถามที่พบบ่อย
Machine Learning แบบ Supervised กับ Unsupervised ต่างกันอย่างไร?
Supervised Learning คือการเรียนรู้แบบมีครู ซึ่งเรามีข้อมูลตัวอย่างพร้อมคำตอบหรือป้ายกำกับ (label) อยู่แล้ว เช่น ราคาแท่งเทียนย้อนหลังที่กำกับว่าแท่งไหน "ขึ้น" แท่งไหน "ลง" แล้วให้โมเดลเรียนรู้รูปแบบที่นำไปสู่คำตอบเหล่านั้น เป้าหมายคือการทำนายผลลัพธ์ เช่น ทำนายราคาหรือจำแนกสแปม ส่วน Unsupervised Learning คือการเรียนรู้แบบไม่มีครู เราโยนข้อมูลดิบให้โมเดลแล้วให้มันหาโครงสร้างหรือกลุ่มที่ซ่อนอยู่เอง เช่น การจัดกลุ่มพฤติกรรมผู้ใช้เว็บไซต์ที่เรายังไม่รู้ว่ามีกี่กลุ่ม ด้วยอัลกอริทึมอย่าง K-Means หรือการวิเคราะห์องค์ประกอบหลัก ทั้งสองแนวทางไม่ได้แข่งกันแต่เสริมกัน ในระบบจริงมักใช้ Unsupervised สำรวจข้อมูลก่อน แล้วค่อยใช้ Supervised สร้างโมเดลทำนายบนความเข้าใจที่ได้มา
จะรู้ได้อย่างไรว่างานของฉันควรใช้ Supervised หรือ Unsupervised?
หลักง่าย ๆ คือถามตัวเองก่อนว่างานที่ทำอยู่เป็นประเภทไหน ถ้างานของคุณมีคำตอบชัดเจนในอดีตอยู่แล้ว เช่น ต้องการทำนายว่าลูกค้าจะยกเลิกสมาชิกหรือไม่ ซึ่งเรารู้คำตอบของลูกค้าเก่าอยู่แล้ว นั่นคืองาน Supervised ทันที แต่ถ้าคำถามของคุณคือ "ข้อมูลชุดนี้มีอะไรที่น่าสนใจซ่อนอยู่" เช่น อยากรู้ว่าสไตล์การเทรดของลูกค้าแบ่งออกเป็นกี่ประเภท นั่นคืองาน Unsupervised สำหรับมือใหม่แนะนำให้เริ่มจาก Supervised ก่อน เพราะวัดผลง่าย มีแนวทางชัดเจน และอธิบายผลลัพธ์ต่อทีมได้เร็ว จากนั้นค่อยเพิ่มทักษะ Unsupervised เพื่อขยายขอบเขตการวิเคราะห์ ลำดับแบบนี้ช่วยให้เส้นทางการเรียนรู้ไม่หนักเกินไป และลดโอกาสเสียเวลาเป็นสัปดาห์กับโมเดลที่ไม่ตอบโจทย์
ควรวัดผลลัพธ์ของโมเดลทั้งสองแบบอย่างไร?
การประเมินผลลัพธ์ของสองแนวทางนี้ต่างกันโดยสิ้นเชิง โมเดล Supervised วัดกันด้วยความแม่นยำ (accuracy) ตัวชี้วัดความแม่นยำสมดุล หรือค่าความคลาดเคลื่อนกำลังสอง เพราะเรามีคำตอบจริงในข้อมูลให้เทียบกันได้ ส่วนโมเดล Unsupervised ไม่มีคำตอบจริงให้เทียบ ต้องวัดด้วยเกณฑ์ภายใน เช่น ความหนาแน่นของกลุ่ม หรือต้องให้ผู้เชี่ยวชาญด้านเนื้อหาตีความว่ากลุ่มที่ได้มีความหมายทางธุรกิจหรือไม่ ข้อควรระวังสำคัญคือถ้าคุณตั้งค่าระบบแล้วคาดหวังว่าจะมี "คะแนนความถูกต้อง" จากโมเดล Unsupervised จะผิดหวังและอาจตัดสินใจผิดพลาดในการนำไปใช้งานจริง ดังนั้นควรกำหนดวิธีประเมินผลให้ชัดเจนตั้งแต่ก่อนเริ่มโปรเจกต์
ต้องเตรียมเครื่องมืออะไรบ้างในการเริ่มต้นทำ Machine Learning?
เครื่องมือหลักที่แนะนำคือภาษาไพธอนคู่กับไลบรารี scikit-learn สำหรับโมเดลพื้นฐานทั้งสองแบบ และไลบรารีหนัก ๆ อย่าง TensorFlow หรือ PyTorch เฉพาะเมื่องานต้องใช้โครงข่ายประสาทเทียมจริง ๆ เท่านั้น เพราะโจทย์ส่วนใหญ่จัดการด้วย scikit-learn ได้หมด ไม่ควรกระโดดไปใช้เครื่องมือหนักตั้งแต่แรก ขั้นตอนการติดตั้งเริ่มจากสร้างสภา
แนะนำเพิ่มเติม
🎯 เปิดบัญชี XM Forex → สมัคร
📱 แอป iCafeFX → ดาวน์โหลด
📊 สัญญาณฟรี → รับสัญญาณ
📚 คู่มือเทรด → SiamCafeBook
🤝 สมัคร Partner XM → pipaffiliates.com/c?c=72816&l=th&p=6
เปิดพอร์ต XM วันนี้ — โบรกที่ อ.บอม ใช้เทรดจริง (พาร์ทเนอร์ XM)
แนะนำจากเครือข่าย SiamCafe
คู่มือ Forex ที่เกี่ยวข้อง
แหล่งอ้างอิง
- SiamCafe.net - ชุมชนไอทีไทยตั้งแต่ปี 1997
- iCafeFX.com - ศูนย์วิเคราะห์ Forex และทองคำ