ai machine learning คือ | SiamCafe Blog
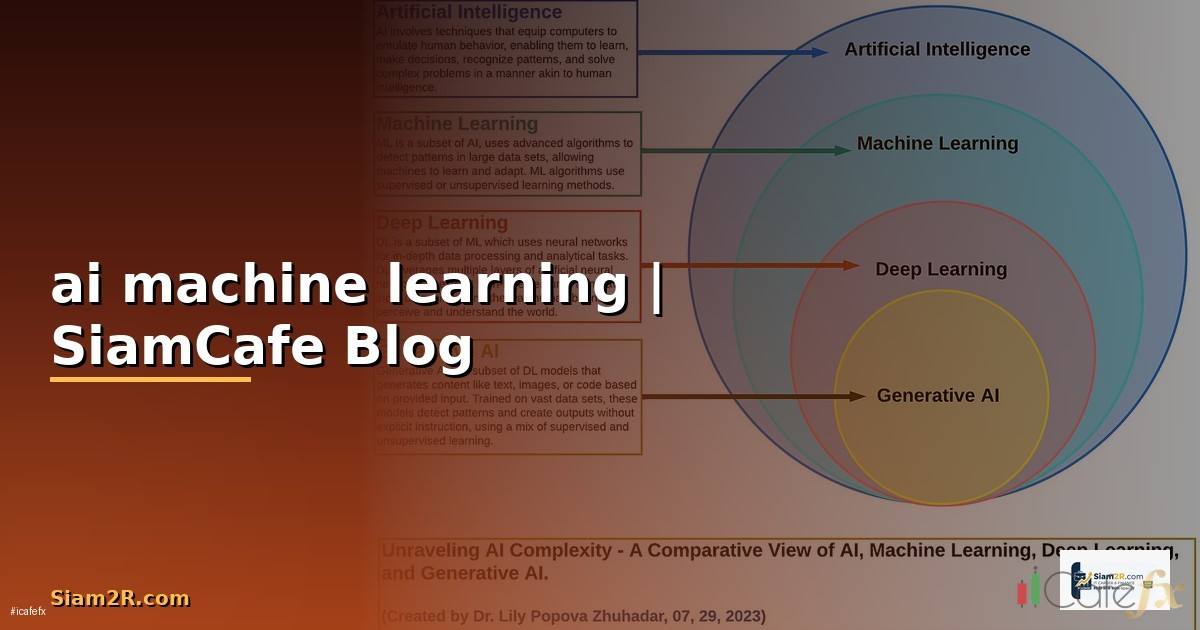
ปัญญาประดิษฐ์และการเรียนรู้ของเครื่อง คืออะไร ทำความเข้าใจตั้งแต่พื้นฐาน
หลายคนเข้าใจผิดว่าปัญญาประดิษฐ์และการเรียนรู้ของเครื่องเป็นเรื่องเดียวกัน แต่จริง ๆ แล้วมันคือความสัมพันธ์แบบ วงกว้างกับวงแคบ —
ปัญญาประดิษฐ์คือศาสตร์กว้าง ๆ ที่พยายามทำให้เครื่องจักรคิดและตัดสินใจได้เหมือนมนุษย์ ส่วนการเรียนรู้ของเครื่องคือหนึ่งในเครื่องมือภายใต้ร่มของปัญญาประดิษฐ์ที่ทำให้คอมพิวเตอร์ "เรียนรู้" จากข้อมูลโดยไม่ต้องเขียนกฎขึ้นเองทุกข้อ
ผมเป็นพ่อค้าอย่างเราใช้แนวคิดนี้ในการเทรดมากว่า 13 ปีแล้ว ก่อนจะมีเครื่องมือสำเร็จรูปอย่างทุกวันนี้ เราต้องนั่งเก็บข้อมูลราคา วิเคราะห์แพทเทิร์นเอง จดสมุด แล้วหากฎจากประสบการณ์ — นั่นแหละคือหัวใจของการเรียนรู้ของเครื่อง แค่ตอนนั้นเราเป็นคนทำเองด้วยมือเปล่า วันนี้คอมพิวเตอร์ทำแทนเราได้เร็วกว่าหลายล้านเท่า
หลักการง่าย ๆ คือ เราป้อนข้อมูลตัวอย่างจำนวนมากให้กับอัลกอริทึม เช่น ข้อมูลราคาหุ้น ข้อมูลลูกค้า หรือภาพถ่าย พร้อมคำตอบที่ถูกต้อง (หรือบางทีก็ไม่มีคำตอบให้ แล้วให้มันหาเอง) จากนั้นระบบจะค่อย ๆ ปรับตัวเองจนสามารถทำนายหรือจัดกลุ่มข้อมูลใหม่ที่ไม่เคยเห็นมาก่อนได้ ยิ่งข้อมูลคุณภาพดีและจำนวนมาก ผลลัพธ์ก็ยิ่งแม่นยำ
ในปี 2026 เทคโนโลยีนี้ไม่ได้อยู่แค่ในห้องแล็บอีกต่อไป มันอยู่ในโทรศัพท์ของเรา ระบบแนะนำสินค้า โปรแกรมตรวจจับการโกง และแน่นอนว่าอยู่ในระบบเทรดที่ผมพัฒนาขึ้นเองด้วย ถ้าคุณเป็นนักพัฒนา เจ้าของธุรกิจ หรือนักเทรดที่อยากต่อยอด การเข้าใจพื้นฐานของศาสตร์นี้จะเป็นตัวตัดสินว่าคุณจะตามโลกทันหรือถูกทิ้งไว้ข้างหลัง
ประเภทของการเรียนรู้ของเครื่อง และการใช้งานจริงในแต่ละแบบ
การเรียนรู้ของเครื่องแบ่งออกเป็นสามประเภทหลัก แต่ละประเภทเหมาะกับงานคนละแบบ การเลือกผิดประเภทตั้งแต่ต้นทำให้เสียเวลาเปล่าเป็นเดือน
การเรียนรู้แบบมีผู้สอน (Supervised Learning) เป็นแบบที่นิยมที่สุด เรามีข้อมูลตัวอย่างพร้อมคำตอบที่ถูกต้องอยู่แล้ว เช่น ข้อมูลลูกค้า 5,000 คน พร้อมข้อมูลว่าใครชำระเงินตรงเวลาใครค้างชำระ แล้วให้ระบบเรียนรู้แพทเทิร์นจากตัวอย่างเหล่านี้ เพื่อทำนายลูกค้ารายใหม่ในอนาคต งานที่ใช้แบบนี้คือการพยากรณ์ราคา การประเมินความเสี่ยง และการจัดหมวดหมู่
การเรียนรู้แบบไม่มีผู้สอน (Unsupervised Learning) ใช้เมื่อเราไม่มีคำตอบสำเร็จรูป ให้ระบบหาความสัมพันธ์หรือกลุ่มในข้อมูลเอง เช่น การแบ่งลูกค้าเป็นกลุ่ม ๆ ตามพฤติกรรมซื้อ โดยที่เราไม่ได้บอกมันว่าควรแบ่งกี่กลุ่มหรือแบ่งด้วยเกณฑ์อะไร ผมใช้แนวนี้ในการจัดกลุ่มสัญญาณเทรดตามลักษณะการเคลื่อนไหวของราคา
การเรียนรู้แบบเสริมแรง (Reinforcement Learning) เป็นแบบที่ระบบลองผิดลองถูกผ่านการทดลอง รับรางวัลเมื่อทำถูก รับโทษเมื่อทำผิด แล้วปรับกลยุทธ์เรื่อย ๆ จนเก่งขึ้น ตัวอย่างที่ใกล้ตัวนักเทรดที่สุดคือระบบเทรดอัตโนมัติที่ปรับกลยุทธ์ตามสภาพตลาด เหมือนมนุษย์ที่เรียนรู้จากการขาดทุนจริง แต่เร็วกว่าและไม่มีอารมณ์เข้ามาเกี่ยวข้อง
| ประเภท | ต้องมีคำตอบตัวอย่างหรือไม่ | ตัวอย่างการใช้งานจริง |
|---|---|---|
| มีผู้สอน | ต้องมี | พยากรณ์ราคา ตรวจจับสแปม ประเมินเครดิต |
| ไม่มีผู้สอน | ไม่ต้องมี | จัดกลุ่มลูกค้า วิเคราะห์พฤติกรรม ลดมิติข้อมูล |
| เสริมแรง | เรียนจากรางวัล/โทษ | ระบบเทรดอัตโนมัติ หุ่นยนต์ การเล่นเกม |
ข้อแนะนำจากประสบการณ์ตรงคือ อย่าเพิ่งกระโดดไปเล่นแบบเสริมแรงตั้งแต่แรก เพราะมันซับซ้อนและใช้ทรัพยากรมากที่สุด เริ่มจากแบบมีผู้สอนกับชุดข้อมูลเล็ก ๆ ที่คุณเข้าใจดี แล้วค่อยขยาย ผมเห็นนักพัฒนาหลายคนหมดไฟกลางทางเพราะเริ่มผิดทาง
หลักการทำงานของการเรียนรู้ของเครื่อง ตั้งแต่ข้อมูลจนถึงการทำนาย
กระบวนการทั้งหมดเป็นวงจรชีวิตที่ชัดเจน ไม่ใช่แค่ป้อนข้อมูลแล้วรอคำตอบ เข้าใจวงจรนี้ช่วยให้คุณวางแผนโปรเจกต์ได้สมเหตุสมผลและรู้ว่าปัญหามักเกิดตรงไหน
ขั้นแรกคือ การเก็บและเตรียมข้อมูล ซึ่งครองสัดส่วนเวลามากถึงเจ็ดสิบถึงแปดสิบเปอร์เซ็นต์ของงานทั้งหมด ข้อมูลดิบในโลกจริงมักมีค่าที่หายไป มีค่าที่ผิดพลาด มีรูปแบบที่ไม่สม่ำเสมอ ต้องทำความสะอาดและจัดรูปแบบให้เรียบร้อยก่อน จากประสบการณ์ทำระบบวิเคราะห์ข้อมูลเทรด ข้อมูลราคาจากโบรกเกอร์ต่างกันมีช่องว่างเวลาและความละเอียดไม่เท่ากัน ถ้าไม่จัดการให้เนียนก่อน แบบจำลองที่ได้จะเพี้ยนโดยที่เราไม่รู้ตัว
ขั้นที่สองคือ การเลือกคุณลักษณะ (Feature Engineering) นี่คือศาสตร์ที่ผมคิดว่าสำคัญที่สุดและมักถูกมองข้าม เราต้องเลือกว่าข้อมูลฟิลด์ไหนมีประโยชน์ต่อการทำนาย ฟิลด์ไหนเป็นสัญญาณรบกวน ในงานเทรด ราคาปิดล้วน ๆ อาจไม่พอ แต่ถ้าคำนวณเป็นช่วงระยะการเคลื่อนไหว อัตราการเปลี่ยนแปลง หรือปริมาณการซื้อขายเทียบกับค่าเฉลี่ย ข้อมูลเหล่านี้ให้ข้อมูลเชิงลึกมากกว่ามาก
ขั้นที่สามคือ การฝึกแบบจำลอง นำข้อมูลที่เตรียมแล้วส่วนหนึ่ง (มักแบ่งเจ็ดส่วนจากสิบ) เข้าสู่อัลกอริทึมเพื่อให้ปรับพารามิเตอร์ภายใน อีกสามส่วนที่เหลือใช้ทดสอบว่าแบบจำลองเก่งจริงหรือแค่จำข้อมูลเดิมได้ จุดนี้แหละที่มือใหม่พลาดบ่อย ถ้าใช้ข้อมูลเดียวกันทั้งฝึกและทดสอบ ตัวเลขความแม่นยำจะสวยงามเกินจริง แต่พอเอาไปใช้กับข้อมูลใหม่ปุ๊บ พังทันที
ขั้นสุดท้ายคือ การประเมินและการนำไปใช้ วัดผลด้วยตัวชี้วัดที่เหมาะกับงาน เช่น ความแม่นยำ ความสามารถในการจับสัญญาณที่ถูกต้อง และปรับจูนจนพอใจ จากนั้นจึงนำไปติดตั้งใช้งานจริง แต่สำคัญคือต้องวางระบบติดตามต่อเนื่อง เพราะโลกเปลี่ยน ข้อมูลเปลี่ยน แบบจำลองที่เคยเก่งเมื่อหกเดือนก่อนอาจใช้ไม่ได้แล้ว ผมจึงมีนัดทบทวนผลลัพธ์ของระบบทุกสัปดาห์เป็นกิจวัตร
ผมจะพูดจากมุมที่ผมถนัดที่สุดก่อน คืองานเทรด ในโลกการเงิน การเรียนรู้ของเครื่องถูกใช้ในหลายระดับ ตั้งแต่การพยากรณ์ทิศทางราคา
การจัดการความเสี่ยงอัตโนมัติ การตรวจจับพฤติกรรมผิดปกติในตลาด ไปจนถึงระบบสัญญาณที่ผมให้บริการ ซึ่งใช้แบบจำลองช่วยกรองสัญญาณที่มีคุณภาพออกจากสัญญาณรบกวน
ผมจะพูดจากมุมที่ผมถนัดที่สุดก่อน คืองานเทรด ในโลกการเงิน การเรียนรู้ของเครื่องถูกใช้ในหลายระดับ ตั้งแต่การพยากรณ์ทิศทางราคา การจัดการความเสี่ยงอัตโนมัติ การตรวจจับพฤติกรรมผิดปกติในตลาด ไปจนถึงระบบสัญญาณที่ผมให้บริการ ซึ่งใช้แบบจำลองช่วยกรองสัญญาณที่มีคุณภาพออกจากสัญญาณรบกวน
แต่ข้อควรระวังอย่างแรง ๆ จากคนที่อยู่ในวงการนี้ 13 ปี — แบบจำลองไม่ใช่ลูกแก้ววิเศษ ตลาดมีความสุ่มสูงมาก แบบจำลองที่ดีที่สุดก็ชนะได้แค่ระยะยาวด้วยอัตราชนะที่ไม่ถึงกับร้อยเปอร์เซ็นต์ ใครก็ตามที่โปรโมตระบบว่าแม่นเป๊ะทุกไม้ นั่นคือการหลอกลวง จงหนีไปให้ไกล หลักการที่ผมยึดคือแบบจำลองช่วยกรองและให้ความน่าจะเป็น ไม่ใช่ให้คำตอบเด็ดขาด การตัดสินใจสุดท้ายยังต้องผ่านระบบบริหารความเสี่ยงของมนุษย์เสมอ
ในมุมธุรกิจทั่วไป การใช้งานจริงที่เห็นผลชัดมีดังนี้
- ระบบแนะนำสินค้า ร้านค้าออนไลน์ใช้พฤติกรรมการเข้าชมเพื่อแนะนำสินค้าที่ลูกค้ามีแนวโน้มซื้อ เพิ่มยอดขายได้จริงโดยไม่ต้องลดราคา
- การประเมินความเสี่ยงเครดิต สถาบันการเงินใช้ประวัติผู้กู้เพื่อคัดกรองให้เร็วขึ้นและลดอคติจากมนุษย์
- การพยากรณ์อุปสงค์ ร้านอาหารหรือโรงแรมใช้ข้อมูลฤดูกาลและวันหยุดวางแผนสต็อก ลดของเหลือทิ้งได้มาก
- การตรวจจับการฉ้อโกง ระบบชำระเงินเรียนรู้แพทเทิร์นปกติของลูกค้าแต่ละคน แล้วแจ้งเตือนเมื่อเกิดพฤติกรรมผิดปกติทันที
คำถามที่ผมได้รับบ่อยที่สุดคือ "อยากเริ่ม ต้องเริ่มจากอะไร" คำตอบของผมมักทำให้หลายคนผิดหวังเล็กน้อย
เพราะมันไม่ใช่การกระโดดไปเล่นเครื่องมือสำเร็จรูปทันที แต่คือการสร้างฐานสามชั้นก่อน
เริ่มต้นเรียนรู้อย่างไร เส้นทางสำหรับผู้เริ่มต้นในปี 2026
คำถามที่ผมได้รับบ่อยที่สุดคือ "อยากเริ่ม ต้องเริ่มจากอะไร" คำตอบของผมมักทำให้หลายคนผิดหวังเล็กน้อย เพราะมันไม่ใช่การกระโดดไปเล่นเครื่องมือสำเร็จรูปทันที แต่คือการสร้างฐานสามชั้นก่อน
ชั้นแรก คือคณิตศาสตร์พื้นฐาน ไม่ต้องถึงระดับปริญญาโท แต่ต้องเข้าใจสถิติเชิงพรรณนา ความน่าจะเป็นพื้นฐาน และพีชคณิตเชิงเส้นระดับเมทริกซ์เบื้องต้น ถ้าไม่มีฐานนี้ คุณจะใช้เครื่องมือได้แต่ไม่เข้าใจว่าทำไมผลลัพธ์ถึงออกมาแบบนั้น ซึ่งเป็นอันตรายมากในงานที่ตัดสินใจด้วยเงินจริง
ชั้นที่สอง คือทักษะการเขียนโปรแกรม ภาษาไพธอนคือมาตรฐานของวงการ มีไลบรารีรองรับครบทุกขั้นตอน ตั้งแต่การจัดการข้อมูล การสร้างแบบจำลอง ไปจนถึงการทำภาพประกอบผลวิเคราะห์ ผมแนะนำให้ฝึกจากงานเล็ก ๆ ที่ใกล้ตัว เช่น ดึงข้อมูลราคาทองมาพล็อตกราฟ คำนวณค่าเฉลี่ยเคลื่อนที่ แล้วค่อย ๆ ต่อยอด
ชั้นที่สาม คือหลักการเรียนรู้ของเครื่อง เริ่มจากอัลกอริทึมคลาสสิกก่อน อย่าเพิ่งกระโดดไปโครงข่ายประสาทเทียมลึก เพราะแบบจำลองแบบง่ายมักพอสำหรับงานส่วนใหญ่และอธิบายผลลัพธ์ได้ง่ายกว่า ศึกษาจากหลักสูตรออนไลน์ฟรีที่มีคุณภาพสูงหลายแห่ง แล้วลงมือทำโปรเจกต์จริงทันที อย่ารอให้เรียนจบก่อนค่อยทำ
| ช่วงเวลา | เป้าหมาย | ผลลัพธ์ที่ควรได้ |
|---|---|---|
| เดือนที่ 1-2 | ไพธอนและสถิติพื้นฐาน | จัดการข้อมูลด้วยโค้ดได้ |
| เดือนที่ 3-4 | อัลกอริทึมพื้นฐาน | สร้างแบบจำลองพยากรณ์ง่าย ๆ ได้ |
| เดือนที่ 5-6 | โปรเจกต์จริง | มีผลงาน 1 ชิ้นที่อธิบายได้ครบวงจร |
| หลัง 6 เดือน | เชี่ยวชาญเฉพาะทาง | เลือกแขนงที่ชอบแล้วลงลึก |
เคล็ดลับที่ผมใช้กับตัวเองตลอด 13 ปีในวงการเทรดคือ "เรียนด้วยการทำ" ความรู้ที่ไม่ได้ลงมือใช้จะหายไปในหนึ่งสัปดาห์ แต่บทเรียนจากความผิดพลาดจริงจะติดตัวไปตลอด อย่ากลัวพลาด กลัวแค่การไม่ได้เริ่ม
ตัวอย่างการประยุกต์ใช้จริง กรณีศึกษาจากประสบการณ์ตรง
ขอเล่าเคสจริงจากงานที่ผมทำ เพื่อให้เห็นภาพว่าทฤษฎีกลายเป็นของใช้จริงอย่างไร เคสแรกคือระบบกรองสัญญาณเทรดของผม ปัญหาเดิมคือระบบสัญญาณสร้างสัญญาณมากเกินไป หลายไม้คุณภาพต่ำ ทำให้สมาชิกที่ตามสัญญาณเสียว้ายเวียน
ทางออกคือการเก็บประวัติสัญญาณย้อนหลังหลายปี พร้อมผลลัพธ์จริงของแต่ละไม้ จากนั้นใช้แบบจำลองแบบมีผู้สอนเรียนรู้ว่าลักษณะสัญญาณแบบไหนมีแนวโน้มชนะสูง ตัวแปรที่ให้น้ำหนักมากที่สุดกลายเป็นเรื่องที่ไม่คาดคิด ไม่ใช่ตัวชี้วัดเทคนิคคลาสสิก แต่เป็นเวลาของวันและสภาพความผันผวนของตลาดช่วงก่อนเกิดสัญญาณ สัญญาณที่เกิดในช่วงตลาดสงบมีอัตราชนะสูงกว่าช่วงตลาดปั่นอย่างชัดเจน หลังนำแบบจำลองมากรอง จำนวนสัญญาณลดลงราวสี่สิบเปอร์เซ็นต์ แต่คุณภาพรวมดีขึ้นมาก สมาชิกพึงพอใจขึ้นทันที
เคสที่สองคืองานให้เพื่อนที่ทำร้านกาแฟ เขามีข้อมูลยอดขายรายวันมาสามปีแต่ไม่เคยใช้ประโยชน์ ผมช่วยสร้างแบบจำลองพยากรณ์ยอดขายรายวันโดยใช้ตัวแปรเช่นวันในสัปดาห์ วันหยุด สภาพอากาศ และโปรโมชัน ความแม่นยำระดับที่ช่วยให้เขาสั่งวัตถุดิบได้แม่นขึ้น เหลือทิ้งน้อยลงราวหนึ่งในสาม ต้นทุนอาหารที่เน่าเสียลดลงเป็นหมื่นบาทต่อเดือน งบที่ลงไปทั้งโปรเจกต์คืนทุนในเวลาไม่ถึงสองเดือน
ข้อสังเกตจากทั้งสองเคส — โปรเจกต์สำเร็จไม่ได้เพราะอัลกอริทึมฉลาดที่สุด แต่เพราะปัญหาชัดเจน ข้อมูลมีอยู่แล้วในมือ และเจ้าของธุรกิจร่วมมือให้ข้อมูลเชิงลึกที่ตัวเลขเพียงอย่างเดียวไม่มี ถ้าคุณกำลังคิดจะเริ่มโปรเจกต์ ให้เริ่มจากคำถามสามข้อ ปัญหาคืออะไร ข้อมูลที่มีอยู่พอไหม และถ้าทำสำเร็จจะเปลี่ยนการตัดสินใจของคุณอย่างไร ถ้าตอบได้ครบสามข้อ ลุยได้เลย ถ้าตอบไม่ได้ ยังไม่ต้องรี
คำถามที่พบบ่อย
ปัญญาประดิษฐ์ (AI) กับการเรียนรู้ของเครื่อง (Machine Learning) ต่างกันอย่างไร?
หลายคนเข้าใจผิดว่าสองอย่างนี้เป็นเรื่องเดียวกัน แต่ความจริงแล้วมันคือความสัมพันธ์แบบวงกว้างกับวงแคบ ปัญญาประดิษฐ์คือศาสตร์กว้าง ๆ ที่พยายามทำให้เครื่องจักรคิด ตรรกะ และตัดสินใจได้เหมือนมนุษย์ ครอบคลุมหลายแขนงด้วยกัน ส่วนการเรียนรู้ของเครื่องเป็นเพียงหนึ่งในเครื่องมือภายใต้ร่มของปัญญาประดิษฐ์ ที่ทำให้คอมพิวเตอร์สามารถ "เรียนรู้" จากข้อมูลตัวอย่างได้โดยไม่ต้องเขียนกฎขึ้นเองทุกข้อ กล่าวคือ Machine Learning เป็นวิธีหนึ่งในการสร้าง AI เท่านั้น เข้าใจความแตกต่างนี้ช่วยให้เลือกใช้เทคโนโลยีได้ถูกทาง เช่น ถ้าต้องการให้ระบบทำนายราคาหรือจัดกลุ่มข้อมูล การเรียนรู้ของเครื่องคือเครื่องมือที่เหมาะสม แต่ถ้าต้องการระบบที่เข้าใจภาษาหรือตัดสินใจซับซ้อนอาจต้องใช้หลายเทคนิครวมกัน นักพัฒนา เจ้าของธุรกิจ หรือนักเทรดที่เข้าใจพื้นฐานนี้จะวางแผนโปรเจกต์ได้แม่นยำกว่าการเข้าใจรวมว่าเป็นสิ่งเดียวกัน
การเรียนรู้ของเครื่องมีกี่ประเภท และแต่ละประเภทเหมาะกับงานแบบไหน?
การเรียนรู้ของเครื่องแบ่งออกเป็นสามประเภทหลัก ประเภทแรกคือการเรียนรู้แบบมีผู้สอน (Supervised Learning) ซึ่งนิยมที่สุด เรามีข้อมูลตัวอย่างพร้อมคำตอบที่ถูกต้องอยู่แล้ว เช่น ข้อมูลลูกค้า 5,000 คนพร้อมประวัติการชำระเงิน เพื่อทำนายลูกค้ารายใหม่ เหมาะกับงานพยากรณ์ราคา ประเมินความเสี่ยง และตรวจจับสแปม ประเภทที่สองคือแบบไม่มีผู้สอน (Unsupervised Learning) ใช้เมื่อไม่มีคำตอบสำเร็จรูป ให้ระบบหากลุ่มหรือความสัมพันธ์เอง เช่น การแบ่งลูกค้าตามพฤติกรรมซื้อ หรือจัดกลุ่มสัญญาณเทรดตามลักษณะการเคลื่อนไหวของราคา ประเภทที่สามคือแบบเสริมแรง (Reinforcement Learning) ระบบเรียนรู้จากการลองผิดลองถูก รับรางวัลเมื่อทำถูกและโทษเมื่อผิด เหมาะกับระบบเทรดอัตโนมัติ หุ่นยนต์ และการเล่นเกม ข้อแนะนำสำคัญคืออย่าเริ่มจากแบบเสริมแรงเพราะซับซ้อนและใช้ทรัพยากรมากที่สุด ควรเริ่มจากแบบมีผู้สอนกับชุดข้อมูลเล็ก ๆ ที่เข้าใจดีก่อนแล้วค่อยขยาย
ขั้นตอนการทำงานของระบบการเรียนรู้ของเครื่องเป็นอย่างไร และปัญหามักเกิดตรงไหน?
กระบวนการทำงานของการเรียนรู้ของเครื่องเป็นวงจรชีวิตที่ชัดเจน ไม่ใช่แค่ป้อนข้อมูลแล้วรอคำตอบ ขั้นแรกคือการเก็บและเตรียมข้อมูล ซึ่งครองสัดส่วนเวลามากถึงเจ็ดสิบถึงแปดสิบเปอร์เซ็นต์ของงานทั้งหมด เพราะข้อมูลดิบในโลกจริงมักมีค่าที่หายไป ค่าที่ผิดพลาด และรูปแบบที่ไม่สม่ำเสมอ ต้องทำความสะอาดก่อนเสมอ เช่น ข้อมูลราคาจากโบรกเกอร์ต่างกันมีช่องว่างเวลาและความละเอียดไม่เท่ากัน ถ้าไม่จัดการให้เรียบร้อย แบบจำลองที่ได้จะเพี้ยนโดยไม่รู้ตัว ขั้นที่สองคือการเลือกคุณลักษณะ (Feature Engineering) ซึ่งเป็นศาสตร์ที่สำคัญที่สุดและมักถูกมองข้าม
แนะนำเพิ่มเติม
🎯 เปิดบัญชี XM Forex → สมัคร
📱 แอป iCafeFX → ดาวน์โหลด
📊 สัญญาณฟรี → รับสัญญาณ
📚 คู่มือเทรด → SiamCafeBook
🤝 สมัคร Partner XM → pipaffiliates.com/c?c=72816&l=th&p=6
เริ่มต้นเทรด Forex กับ XM — โบรกที่ อ.บอม ใช้เทรดจริง (พาร์ทเนอร์ XM)
แนะนำจากเครือข่าย SiamCafe
คู่มือ Forex ที่เกี่ยวข้อง
แหล่งอ้างอิง
- SiamCafe.net - ชุมชนไอทีไทยตั้งแต่ปี 1997
- iCafeFX.com - ศูนย์วิเคราะห์ Forex และทองคำ