Parquet Format กับ Cost Optimization — ลดค่าใช้จ่าย Cloud Storage และ Query ด้วย Columnar Format | SiamCafe Blog
Parquet Format กับ Cost Optimization — ลดค่าใช้จ่าย Cloud Storage และ Query ด้วย Columnar Format | SiamCafe Blog
ในยุคที่ข้อมูลกลายเป็นทรัพยากรสำคัญที่สุดขององค์กร การจัดการต้นทุนด้านคลาวด์จึงไม่ใช่แค่เรื่องเทคนิค แต่คือหัวใจของความยั่งยืนทางธุรกิจ
โดยเฉพาะเมื่อต้องจัดการข้อมูลขนาดใหญ่ที่ไหลเข้ามาอย่างต่อเนื่อง ไม่ว่าจะเป็นข้อมูลจาก IoT, การซื้อขายออนไลน์ หรือระบบบันทึกเหตุการณ์ (logs) ซึ่งในหลายกรณี ข้อมูลเหล่านี้ถูกเก็บในรูปแบบ CSV หรือ JSON ที่ดูเรียบง่าย แต่กลับกลายเป็นต้นทุนซ่อนเร้นที่กินพื้นที่จัดเก็บและเพิ่มค่าใช้จ่ายในการ Query อย่างไม่จำเป็น อ.บอม ผู้ซึ่งเคยใช้ XM เป็นเครื่องมือในการวิเคราะห์ตลาดหุ้นและเงินตราในช่วง 13 ปีที่ผ่านมา ได้เรียนรู้มาแล้วว่า “ความแม่นยำในการตัดสินใจ” ขึ้นอยู่กับ “ความเร็วในการเข้าถึงข้อมูล” — และนั่นคือจุดเริ่มต้นของความเข้าใจใน Parquet Format ว่าทำไมมันจึงเป็นเครื่องมือสำคัญในการลดต้นทุน Cloud ได้อย่างมีนัยสำคัญ
Parquet เป็นรูปแบบการจัดเก็บข้อมูลแบบ Columnar (เก็บข้อมูลตามคอลัมน์) ที่พัฒนาโดย Apache เป็น open-source โดยออกแบบมาเพื่อรองรับงานด้าน Big Data Analytics โดยเฉพาะในระบบที่ต้อง Query ข้อมูลเฉพาะบางคอลัมน์ เช่น คำนวณยอดขายจากคอลัมน์ “ยอดเงิน” โดยไม่ต้องอ่านข้อมูล “ชื่อลูกค้า” หรือ “ที่อยู่” ทั้งหมด ซึ่งในระบบ Row-based อย่าง CSV ต้องอ่านทุกบันทึกทั้งหมดก่อน ทำให้สิ้นเปลืองทรัพยากรอย่างมาก แต่ Parquet สามารถอ่านเฉพาะคอลัมน์ที่ต้องการได้ทันที พร้อมกับบีบอัดข้อมูลได้อย่างมีประสิทธิภาพ เพราะข้อมูลในคอลัมน์เดียวกันมักมีลักษณะคล้ายกัน เช่น ค่าตัวเลขที่ใกล้เคียงกัน หรือข้อความที่ซ้ำกัน ทำให้สามารถบีบอัดได้ถึง 80–90% เมื่อเทียบกับ CSV ที่บีบอัดได้เพียง 60% เท่านั้น
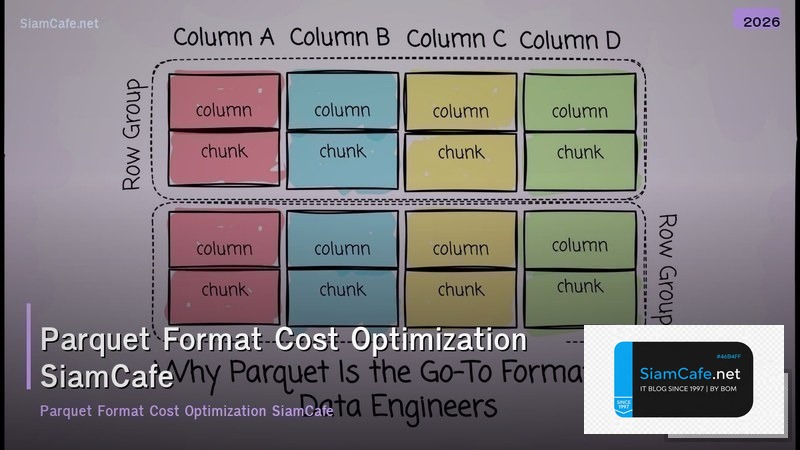
สิ่งที่ทำให้ Parquet โดดเด่นยิ่งกว่าคือการมี Schema ภายในไฟล์ (Schema Evolution) ซึ่งช่วยให้เครื่องมือต่าง ๆ สามารถอ่านข้อมูลได้อย่างถูกต้องโดยไม่ต้องพึ่งพา metadata ภายนอก และรองรับ Predicate Pushdown ซึ่งช่วยให้ระบบ Query Engine สามารถกรองข้อมูลได้ก่อนอ่านไฟล์จริง ทำให้ลดจำนวน Row Groups ที่ต้องเปิดอ่านได้อย่างมาก โดยเฉพาะเมื่อใช้ร่วมกับ Partitioning Strategy อย่าง Hive-style เช่น การแบ่งตามปี/เดือน/วัน หรือตามประเภทสินค้า ซึ่งเป็นกลยุทธ์ที่ใช้ได้ผลดีในงานวิเคราะห์ข้อมูลเชิงลึก (deep analytics) ที่ต้องการความเร็วและประสิทธิภาพสูงสุด
---
ในโลกของ Cloud Computing ต้นทุนไม่ได้วัดแค่แค่ CPU หรือ RAM แต่รวมถึง Storage ที่ใช้จัดเก็บข้อมูล ซึ่งในหลายกรณี ข้อมูลที่ถูกเก็บไว้ในรูปแบบ CSV หรือ
JSON กลับกลายเป็น “ก้อนหิน” ที่กินพื้นที่โดยไม่จำเป็น อ.บอม ที่เคยติดตามต้นทุนการซื้อขายในตลาด Forex ผ่าน XM รู้ดีว่า “การจัดการต้นทุน” คือหัวใจของผลตอบแทนที่ยั่งยืน ซึ่งในโลกของ Data นั่นหมายถึงการลดขนาดไฟล์ให้เล็กลงโดยไม่เสียข้อมูล นั่นคือจุดแข็งหลักของ Parquet
ในโลกของ Cloud Computing ต้นทุนไม่ได้วัดแค่แค่ CPU หรือ RAM แต่รวมถึง Storage ที่ใช้จัดเก็บข้อมูล ซึ่งในหลายกรณี ข้อมูลที่ถูกเก็บไว้ในรูปแบบ CSV หรือ JSON กลับกลายเป็น “ก้อนหิน” ที่กินพื้นที่โดยไม่จำเป็น อ.บอม ที่เคยติดตามต้นทุนการซื้อขายในตลาด Forex ผ่าน XM รู้ดีว่า “การจัดการต้นทุน” คือหัวใจของผลตอบแทนที่ยั่งยืน ซึ่งในโลกของ Data นั่นหมายถึงการลดขนาดไฟล์ให้เล็กลงโดยไม่เสียข้อมูล นั่นคือจุดแข็งหลักของ Parquet
การบีบอัดข้อมูลแบบ Columnar ของ Parquet ทำให้ขนาดไฟล์ลดลงได้ถึง 60–90% เมื่อเทียบกับ CSV หรือ JSON ที่เก็บข้อมูลแบบ Row-based ซึ่งมี overhead มากกว่า เช่น การเก็บข้อมูลซ้ำในชื่อคอลัมน์ทุกแถว หรือการใช้หน่วยความจำในการเก็บข้อมูลที่ไม่จำเป็น ตัวอย่างเช่น ข้อมูลขนาด 500 GB ที่เก็บในรูปแบบ CSV อาจลดลงเหลือเพียง 50–100 GB เมื่อแปลงเป็น Parquet ซึ่งหมายถึงการลดค่าใช้จ่ายด้าน Storage ลงอย่างมาก โดยเฉพาะเมื่อใช้บริการอย่าง AWS S3, Google Cloud Storage หรือ Azure Blob Storage ที่เรียกเก็บตามปริมาณข้อมูลที่จัดเก็บ
นอกจากนี้ Parquet ยังรองรับการแบ่งข้อมูลออกเป็น Partition ตามคอลัมน์ที่ใช้บ่อย เช่น วันที่ หรือภูมิภาค ทำให้ Query Engine สามารถทำ “Partition Pruning” ได้ กล่าวคือ อ่านเฉพาะ Partition ที่เกี่ยวข้องกับเงื่อนไขการค้นหา เช่น ดึงข้อมูลเฉพาะเดือนมีนาคม 2026 แทนที่จะต้องเปิดไฟล์ทั้งหมด ซึ่งช่วยลดจำนวนไฟล์ที่ต้องอ่าน และลดค่าใช้จ่ายด้าน Data Transfer ได้อย่างมีนัยสำคัญ
ยิ่งไปกว่านั้น เมื่อใช้กับบริการ Query บนคลาวด์อย่าง Amazon Athena หรือ BigQuery การที่ Parquet อ่านเฉพาะคอลัมน์ที่ต้องการ (Column Pruning) ทำให้ระบบต้องอ่านข้อมูลน้อยลง ซึ่งส่งผลโดยตรงต่อค่าใช้จ่ายของ Query ที่เรียกเก็บตามปริมาณข้อมูลที่อ่าน ดังนั้น แม้จะมี Query จำนวนมากในแต่ละเดือน การใช้ Parquet สามารถลดค่าใช้จ่าย Query ได้หลายร้อยดอลลาร์ต่อเดือน โดยเฉพาะในงานวิเคราะห์ข้อมูลที่ต้อง Query ข้อมูลขนาดใหญ่เป็นประจำ
ในงานวิเคราะห์ข้อมูลขนาดใหญ่ การเรียกใช้ Query ที่มีประสิทธิภาพสูงสุดคือหัวใจของการลดต้นทุนในระยะยาว อ.บอม ที่เคยใช้ XM ในการติดตามสัญญาณตลาด
รู้ดีว่า “การตัดสินใจที่ดี” เกิดจาก “ข้อมูลที่ถูกต้อง” และ “ข้อมูลที่เข้าถึงได้เร็ว” ซึ่งในโลกของ Data Engineering นั่นหมายถึงการลดเวลาและทรัพยากรที่ใช้ในการ Query ข้อมูล ซึ่ง Parquet ถูกออกแบบมาเพื่อตอบโจทย์นี้โดยตรงผ่านกลไกสำคัญสองประการ คือ Column Pruning และ Predicate Pushdown
การลด Query Cost ด้วย Column Pruning และ Predicate Pushdown ใน Parquet
ในงานวิเคราะห์ข้อมูลขนาดใหญ่ การเรียกใช้ Query ที่มีประสิทธิภาพสูงสุดคือหัวใจของการลดต้นทุนในระยะยาว อ.บอม ที่เคยใช้ XM ในการติดตามสัญญาณตลาด รู้ดีว่า “การตัดสินใจที่ดี” เกิดจาก “ข้อมูลที่ถูกต้อง” และ “ข้อมูลที่เข้าถึงได้เร็ว” ซึ่งในโลกของ Data Engineering นั่นหมายถึงการลดเวลาและทรัพยากรที่ใช้ในการ Query ข้อมูล ซึ่ง Parquet ถูกออกแบบมาเพื่อตอบโจทย์นี้โดยตรงผ่านกลไกสำคัญสองประการ คือ Column Pruning และ Predicate Pushdown
Column Pruning คือความสามารถของ Parquet ที่ช่วยให้ Query Engine สามารถอ่านเฉพาะคอลัมน์ที่ต้องการได้ โดยไม่ต้องโหลดข้อมูลทั้งหมดในแต่ละแถว ตัวอย่างเช่น หากต้องการหาค่าเฉลี่ยของ “ยอดขาย” จากข้อมูล 10 ล้านแถว ระบบจะอ่านเฉพาะคอลัมน์ “ยอดขาย” ที่อยู่ในรูปแบบ Columnar ที่จัดเรียงกันอย่างต่อเนื่อง ทำให้การอ่านข้อมูลมีประสิทธิภาพสูงและใช้ Memory น้อยลง ตรงข้ามกับ CSV ที่ต้องอ่านทุกคอลัมน์ในทุกแถว แล้วค่อยกรองทีหลัง ซึ่งส่งผลให้ Query ช้าและใช้ทรัพยากรมาก
Predicate Pushdown คือกลไกที่ช่วยให้เงื่อนไขการกรอง (เช่น WHERE วันที่ > ‘2026-03-01’) ถูกประมวลผลก่อนที่ข้อมูลจะถูกอ่านจาก Disk หรือ Storage โดย Query Engine สามารถใช้ Min/Max Statistics ที่เก็บไว้ในแต่ละ Row Group เพื่อตัด Row Groups ที่ไม่เกี่ยวข้องออกไปได้ทันที ทำให้ไม่ต้องโหลดข้อมูลที่ไม่จำเป็นมาประมวลผล ซึ่งช่วยลด I/O และเพิ่มความเร็วในการ Query ได้อย่างมาก โดยเฉพาะเมื่อข้อมูลถูกเรียงลำดับตามคอลัมน์ที่ใช้กรองบ่อย ๆ เช่น วันที่ หรือรหัสสินค้า
กลยุทธ์นี้ทำงานได้ดีที่สุดเมื่อใช้ร่วมกับ Partitioning Strategy ที่เหมาะสม เช่น การแบ่งข้อมูลตามวันที่ (partition by date) หรือตามภูมิภาค (partition by region) ซึ่งช่วยให้ระบบสามารถข้าม Partition ที่ไม่เกี่ยวข้องได้ทันที ทำให้ Query ที่ต้องกรองข้อมูลตามช่วงเวลา หรือภูมิภาค ทำงานได้เร็วขึ้นหลายเท่า ตัวอย่างเช่น การ Query ข้อมูลเฉพาะเดือนมีนาคม 2026 จากข้อมูลทั้งปี จะต้องอ่านเพียง Partition เดียว แทนที่จะต้องเปิดไฟล์ทั้งหมด
| คุณสมบัติ | CSV | JSON | Parquet |
|---|---|---|---|
| รูปแบบการจัดเก็บ | Row-based | Row-based | Columnar |
| การบีบอัด | ต่ำ (~60%) | ต่ำ (~65%) | สูง (~80–90%) |
| Column Pruning | ไม่ได้ | ไม่ได้ | ได้ |
| Predicate Pushdown | ไม่ได้ | ไม่ได้ | ได้ |
| Schema | ไม่มี | ไม่มี (semi-structured) | มีในตัว |
| อ่านง่ายด้วย Text Editor | ได้ | ได้ | ไม่ได้ (Binary) |
การใช้ Parquet ไม่ใช่แค่การแปลงไฟล์จาก CSV เป็น Parquet แล้วจบ
แต่คือการปรับใช้กลยุทธ์อย่างชาญฉลาดเพื่อให้ได้ประโยชน์สูงสุดทั้งด้านต้นทุนและประสิทธิภาพ อ.บอม ที่เคยใช้ XM ในการวิเคราะห์ตลาดอย่างละเอียด รู้ดีว่า “ความสำเร็จ” ไม่ได้มาจากการทำทุกอย่าง แต่มาจากการเลือกทำสิ่งที่ให้ผลตอบแทนสูงสุด ซึ่งในด้าน Data นั่นหมายถึงการตั้งค่า Parquet ให้เหมาะสมกับรูปแบบการ Query ของระบบ
---
Best Practices ในการใช้ Parquet เพื่อ Cost Optimization สูงสุด
การใช้ Parquet ไม่ใช่แค่การแปลงไฟล์จาก CSV เป็น Parquet แล้วจบ แต่คือการปรับใช้กลยุทธ์อย่างชาญฉลาดเพื่อให้ได้ประโยชน์สูงสุดทั้งด้านต้นทุนและประสิทธิภาพ อ.บอม ที่เคยใช้ XM ในการวิเคราะห์ตลาดอย่างละเอียด รู้ดีว่า “ความสำเร็จ” ไม่ได้มาจากการทำทุกอย่าง แต่มาจากการเลือกทำสิ่งที่ให้ผลตอบแทนสูงสุด ซึ่งในด้าน Data นั่นหมายถึงการตั้งค่า Parquet ให้เหมาะสมกับรูปแบบการ Query ของระบบ
ข้อแนะนำข้อแรกคือการเลือกอัลกอริธึมการบีบอัด (Compression) ที่เหมาะสม ซึ่ง Parquet รองรับหลายรูปแบบ เช่น Snappy, Gzip และ Zstd โดย Snappy เหมาะกับงานที่ต้องการความเร็วในการอ่าน/เขียน แต่บีบอัดได้ไม่ลึกเท่า Gzip ซึ่งเหมาะกับงานที่ต้องการลดขนาดไฟล์สุด ๆ แต่ใช้ CPU มากกว่า ในขณะที่ Zstd ให้สมดุลระหว่างขนาดไฟล์และความเร็ว จึงเป็นตัวเลือกที่ดีที่สุดในหลายกรณี โดยเฉพาะเมื่อต้องการลดต้นทุน Cloud ทั้งด้าน Storage และ Query
อีกข้อสำคัญคือการตั้งขนาดของ Row Group ให้เหมาะสม ควรอยู่ระหว่าง 128 MB ถึง 1 GB ต่อ Row Group ขนาดเล็กเกินไปจะทำให้บีบอัดไม่ดี และเพิ่มจำนวน Row Group ที่ต้องอ่าน ขนาดใหญ่เกินไปจะใช้ Memory มากในการอ่าน ทำให้ Query ช้าลง
สมมติว่าเรามีข้อมูลคำสั่งซื้อขนาด 500 GB ในรูปแบบ CSV ที่ถูกเก็บใน AWS S3 และมีการ Query ทุกวันเพื่อวิเคราะห์ยอดขายรายวัน โดย Query ต้องกรองตามวันที่
และอ่านเฉพาะคอลัมน์ “วันที่” และ “ยอดเงิน” ซึ่งในปัจจุบัน ระบบใช้ Amazon Athena ในการ Query ค่าใช้จ่ายเฉลี่ยต่อเดือนอยู่ที่ประมาณ $1,200
สุดท้าย ควรเรียงข้อมูล (Sort) ก่อนเขียนไฟล์ Parquet โดยเฉพาะตามคอลัมน์ที่ใช้กรองบ่อย เช่น วันที่ หรือรหัสลูกค้า เพราะช่วยให้ Min/Max Statistics ภายใน Row Group ทำงานได้ดี ทำให้ Predicate Pushdown สามารถตัด Row Group ที่ไม่เกี่ยวข้องได้เร็วขึ้น
---
ตัวอย่างการปฏิบัติ: แปลง CSV เป็น Parquet เพื่อลดต้นทุนในระบบวิเคราะห์ข้อมูล
สมมติว่าเรามีข้อมูลคำสั่งซื้อขนาด 500 GB ในรูปแบบ CSV ที่ถูกเก็บใน AWS S3 และมีการ Query ทุกวันเพื่อวิเคราะห์ยอดขายรายวัน โดย Query ต้องกรองตามวันที่ และอ่านเฉพาะคอลัมน์ “วันที่” และ “ยอดเงิน” ซึ่งในปัจจุบัน ระบบใช้ Amazon Athena ในการ Query ค่าใช้จ่ายเฉลี่ยต่อเดือนอยู่ที่ประมาณ $1,200
เพื่อลดต้นทุน เราจะดำเนินการแปลงข้อมูลดังนี้:
แปลง CSV เป็น Parquet ด้วย DuckDB หรือ Python (Pandas) โดยใช้คำสั่งเช่น import pandas as pd df = pd.read_csv('sales.csv') df.to_parquet('sales.parquet', compression='zstd', index=False)
ตั้ง Partitioning Strategy โดยแบ่งข้อมูลตามวันที่ (partition by date) ด้วยโครงสร้างโฟลเดอร์แบบ Hive-style: s3://my-bucket/data/year=2026/month=03/day=05/sales.parquet
ตั้ง Row Group Size ให้เหมาะสม (128 MB – 256 MB) และใช้ `zstd` สำหรับการบีบอัด
เรียงข้อมูลตามวันที่ ก่อนเขียนไฟล์ เพื่อให้ Min/Max Statistics ทำงานได้ดี
หลังจากดำเนินการแล้ว ขนาดไฟล์จะลดลงเหลือประมาณ 80 GB ทำให้ค่าใช้จ่ายด้าน Storage ลดลงเกือบ 90% และเมื่อ Query ด้วย Athena จะอ่านเฉพาะ Partition ที่เกี่ยวข้อง และเฉพาะคอลัมน์ที่ต้องการ ทำให้ค่าใช้จ่าย Query ลดลงเหลือเพียง $150–$200 ต่อเดือน หรือลดลงกว่า 80% ภายในเวลาไม่กี่วัน
---
คำถามที่พบบ่อย
Q: ควรใช้ Parquet แทน CSV ได้ทันทีหรือไม่?
A: ไม่จำเป็นต้องเปลี่ยนทันทีทุกกรณี ควรใช้ Parquet เมื่อข้อมูลมีขนาดใหญ่ (100 MB ขึ้นไป) และต้อง Query แบบ Analytical ที่ต้องอ่านเฉพาะบางคอลัมน์ หรือต้องการลดต้นทุน Cloud Storage และ Query Cost อย่างมีนัยสำคัญ แต่หากข้อมูลเล็กมาก (ไม่ถึง 10 MB) หรือต้องอ่านด้วย Text Editor บ่อย ๆ หรือ Append ข้อมูลทีละแถว ควรใช้ CSV หรือ JSON แทน เพราะ Parquet ไม่เหมาะกับการเขียนทีละแถว และไม่สามารถอ่านด้วยมือได้
Q: Parquet ใช้ได้กับบริการคลาวด์ใดบ้าง?
A: Parquet รองรับได้ทุกแพลตฟอร์มคลาวด์ที่รองรับ Data Lake หรือ Data Warehouse โดยเฉพาะ AWS S3 ร่วมกับ Athena หรือ Redshift, Google Cloud Storage ร่วมกับ BigQuery, Azure Blob Storage ร่วมกับ Synapse Analytics และบริการอื่น ๆ ที่รองรับ Parquet เช่น Apache Spark, Trino, Flink ซึ่งทำให้เป็นมาตรฐานอุตสาหกรรมที่ใช้กันอย่างแพร่หลายในงาน Big Data Analytics
Q: ทำไม Parquet ถึงไม่เหมาะกับการ Append ข้อมูลทีละแถว?
A: เพราะ Parquet จัดเก็บข้อมูลในรูปแบบ Columnar ที่ต้องเขียนทั้งไฟล์ใหม่เมื่อมีการเปลี่ยนแปลง ทำให้การเพิ่มข้อมูลทีละแถวต้องเขียนไฟล์ใหม่ทุกครั้ง ซึ่งส่งผลให้ประสิทธิภาพต่ำมากเมื่อต้องเขียนบ่อย ๆ ต่างจาก CSV ที่สามารถ Append ได้ง่าย ดังนั้น Parquet เหมาะกับงานที่เขียนครั้งเดียว แล้วอ่านซ้ำหลายครั้ง (read-heavy) ไม่ใช่ write-heavy
Q: ควรใช้ Compression แบบไหนดีที่สุดสำหรับ Parquet?
A: ขึ้นอยู่กับเป้าหมาย ถ้าต้องการความเร็วสูงสุด ใช้ Snappy ถ้าต้องการลดขนาดไฟล์สุด ๆ ใช้ Gzip แต่ใช้ CPU มาก สำหรับสมดุลระหว่างขนาดและความเร็ว แนะนำให้ใช้ Zstd เพราะบีบอัดได้ดีกว่า Snappy และเร็วกว่า Gzip จึงเป็นตัวเลือกที่ดีที่สุดในหลายกรณี โดยเฉพาะเมื่อต้องการลดต้นทุน Cloud ทั้งด้าน Storage และ Query
แนะนำเพิ่มเติม
🎯 เปิดบัญชี XM Forex → สมัคร
📱 แอป iCafeFX → ดาวน์โหลด
📊 สัญญาณฟรี → รับสัญญาณ
📚 คู่มือเทรด → SiamCafeBook
🤝 สมัคร Partner XM → pipaffiliates.com/c?c=72816&l=th&p=6
แนะนำจากเครือข่าย SiamCafe
คู่มือ Forex ที่เกี่ยวข้อง
แหล่งอ้างอิง
- SiamCafe.net - ชุมชนไอทีไทยตั้งแต่ปี 1997
- iCafeFX.com - ศูนย์วิเคราะห์ Forex และทองคำ